

Retrieval-Augmented Generation (RAG)
LLM chatbot တွေသုံးတဲ့အခါမှာ hallucination ပြသနာတွေ Online ပေါ်က Rumors/ Fake News တွေလို Data source တွေကြောင့် LLM တွေရဲ့ Output က Reliable မဖြစ်တာတွေ ကြုံဖူးကြလား?
Enterprise AI တွေအတွက် အယ့်ဒီပြဿနာကိုဖြေရှင်းဖို့ RAG ရှိပါတယ်။
RAG ဆိုတာ LLM တွေကို ချိတ်ဆက်ထားတဲ့ သက်ဆိုင်ရာ ဒေတာ source တွေကနေ ဖြေပြန်ထုတ်ပေးတာလို့ အကြမ်းဖျင်းမှတ်ယူနိုင်ပါတယ်။
ဥပမာ - User က Sale နဲ့ပတ်သတ်တဲ့ prompt ပေးရင် Sale Data ရှိတဲ့နေရာကို Retrieval သွားလုပ်တယ်။ Inventory နဲ့ပတ်သက်တာ Prompt မှာမေးရင် Inventory နဲ့ပတ်သက်တဲ့ ချိတ်ထားတဲ့ Data ကိုသွားတယ်။
ပြီးတော့အယ့်နေရာကနေ ရှာလို့တွေ့တဲ့ Data ( Retrieved Context) နဲ့ User မေးတဲ့ Query ကို ပေါင်းလိုက်တယ်။ အယ့်ဒုတိယအဆင့်ကိုတော့ Augmentation Process လို့ခေါ်ပါတယ်။
နောက်ဆုံးအနေနဲ့ ရလာတဲ့ Augmented Retrived Context ကိုဘဲ ကိုးကားပြီး User ကို Output ပြန်ထုတ်ပေးပါတယ်။
သက်ဆိုင်ရာ ဒေတာ source တွေကိုချိတ်ဆက်ထားတာဖြစ်တဲ့အတွက် LLM တွေရဲ့အားနည်းချက်ဖြစ်တဲ့ Hallucation ဖြစ်တာတွေ Online ကတွေ့ကရာ ဒေတာတွကို ဖတ်လာပြီး ရမ်းရွှီးတာမျိုး လုပ်လို့မရတော့ပါတော့ဘူး။
Enterprise RAG တွေမှာ တကယ်တမ်း အသုံးပြုကြတဲ့အခါ Data တွေက နေရာတစ်နေရာတည်း (သို့မဟုတ်) ပုံစံတစ်မျိုးတည်းမှာ ရှိမနေပါဘူး။ Sales Data က SQL Database ထဲမှာ၊ HR Policy တွေက PDF တွေနဲ့ Vector Database ထဲမှာ၊ Customer Data က CRM ထဲမှာ စသဖြင့်ပုံစံမျိုးစုံရှိတတ်ပါတယ်။
ဒီလိုမျိုး Data တွေ အများကြီးရှိတဲ့အခါ User မေးသမျှကို နေရာတကာ လိုက်ရှာနေရင် အချိန်ကြာမယ်၊ တစ်နေရာပြီးတစ်နေရာလိုက်ရှာရတဲ့အတွက် မလိုအပ်ဘဲ Token cost တွေကုန်မယ် ၊ ပြီးတော့ မဆိုင်တဲ့ အချက်အလက်တွေပါ ရောပါလာပြီး AI က အဖြေမှားတွေ ပေးနိုင်ပါတယ်။
ဒီပြဿနာကို ဖြေရှင်းဖို့ RAG မှာသုံးတဲ့ Query Routing / Semantic Routing ကို ကြားခံအဖြစ် သုံးကြပါတယ်။
Query Routing
အလုပ်လုပ်ပုံအဆင့်ဆင့်
၁။ User Prompt ယူတယ်
၂။ Routing Engine: ဒီမေးခွန်းက ဘယ်အကြောင်းအရာနဲ့ သက်ဆိုင်လဲဆိုတာကို Router က ဆုံးဖြတ်တယ်။
၃။ လမ်းကြောင်းလွှဲပေးခြင်း: ဆုံးဖြတ်ချက်အပေါ် မူတည်ပြီး ချိတ်ဆက်ထားတဲ့သက်ဆိုင်ရာ Datasource ကိုဘဲ တိုက်ရိုက် သွားပြီး ရှာစေပါတယ်။
ဥပမာအနေနဲ့
User Prompt - "မနေ့က ရန်ကုန်ဆိုင်ခွဲမှာ ဘယ်လောက် ရောင်းရလဲ" ဆိုရင်
Router ရဲ့ အလုပ် က ဒီ Prompt က Sale နဲ့ ဆိုင်တဲ့အတွက် မဆိုင်တဲ့ တစ်ခြား Datasource တွေဆီမလွှတ်ဘဲ၊ Sales SQL Database ဆီကို လမ်းကြောင်းလွှဲပြီး Query ထုတ်ခိုင်းပါတယ်။
Query Routing Method များ | အလုပ်လုပ်ပုံ | အားသာချက် | အားနည်းချက် |
၁။ Logical / Keyword Routing | Prompt ထဲမှာ "Sale", "Price" ပါရင် အရောင်းပိုင်း၊ "Leave", "Salary" ပါရင် HR ပိုင်း စသဖြင့် စကားလုံး (Keyword) တွေ၊ Rule တွေနဲ့ ခွဲပါတယ်။ | Simple & Fast တော့ဖြစ် | Prompt က စကားလုံးပြောင်းသုံးရင် (ဥပမာ- "ခွင့်" အစား "နားရက်") System က နားမလည်တော့။ |
၂။ LLM-based Routing | Prompt ကို နောက်ထပ် LLM အသေးစားတစ်ခုဆီ အရင်ပို့ပြီး "ဒီမေးခွန်းက Sale လား၊ HR လား ရွေးပေး" လို့ ဆုံးဖြတ်ခိုင်းပါတယ်။ | တိကျပြီး Complex ဖြစ်တဲ့ မေးခွန်းတွေကိုပါ နားလည်နိုင် | LLM ကို ခေါ်ရတဲ့အတွက် အချိန်အနည်းငယ် ပိုကြာပြီး အယ့်အတွက် Token ဖိုးထပ်ကုန်။ |
၃။ Semantic Routing | မေးခွန်းကို Embedding ပြောင်းလိုက်ပြီး၊ Data Source တွေကို Similarity Search နဲ့ ရှာပြီး အနီးစပ်ဆုံးကို ရွေးချယ်ပါတယ်။ | LLM ကို ထပ်ခေါ်စရာမလိုဘဲ အဓိပ္ပါယ်ကို နားလည်တဲ့အတွက် ပိုတိကျ/ပိုမြန်/ကုန်ကျစရိတ် သက်သာပါတယ်။ | စာသားတွေကို Vector ပြောင်းပေးတဲ့ Embedding Model မကောင်းရင်လဲ ကောင်းကောင်းအလုပ်မလုပ်ပါဘူး။ အထူးသဖြင့် Jargon တွေ၊ ဗန်းစကားတွေကို Embedding Model က သေချာနားမလည်ရင် အဓိပ္ပါယ်လွဲချော်ပြီး Routing မှားတတ်ပါတယ်။ |
Logical/Keyword Routing ကိုတော့ ကျွန်တာ်လုပ်ပေးဘူးသမျှ Enterprise တွေမှာမတွ့ဘူးသေးပေမယ့် LLM-based Routing နဲ့ Semantic Routing ကတော်တော်လေးအသုံးများလာကြပါတယ်။ ဒီနောက်ပိုင်း Client Requirement တွေများလာပြီး Complex ဖြစ်လာရင် တော့ Hybrid Routing (Semantic လည်းသုံး၊ Semantic နဲ့ မရတဲ့ Complex ဖြစ်တဲ့မေးခွန်းတွေအတွက် LLM based Route ကိုလည်း တွဲသုံးတဲ့နည်းလမ်း ကိုလဲသုံးလာကြပါတယ်။ Semantic Routing နဲ့ LLM-based Routing ရဲ့ Sample Python code ကို Google Colab ပေါ်မှာရေးပြထားပါတယ်။ မိမိရဲ့ OpenAI API Key ထည့်စမ်းလို့ရပါတယ် ၊၊
library version က changes အမြဲရှိနိုင်တဲ့အတွက် Library Doc ဖတ်စမ်းကြဖို့အကြံပြုလိုပါတယ်။
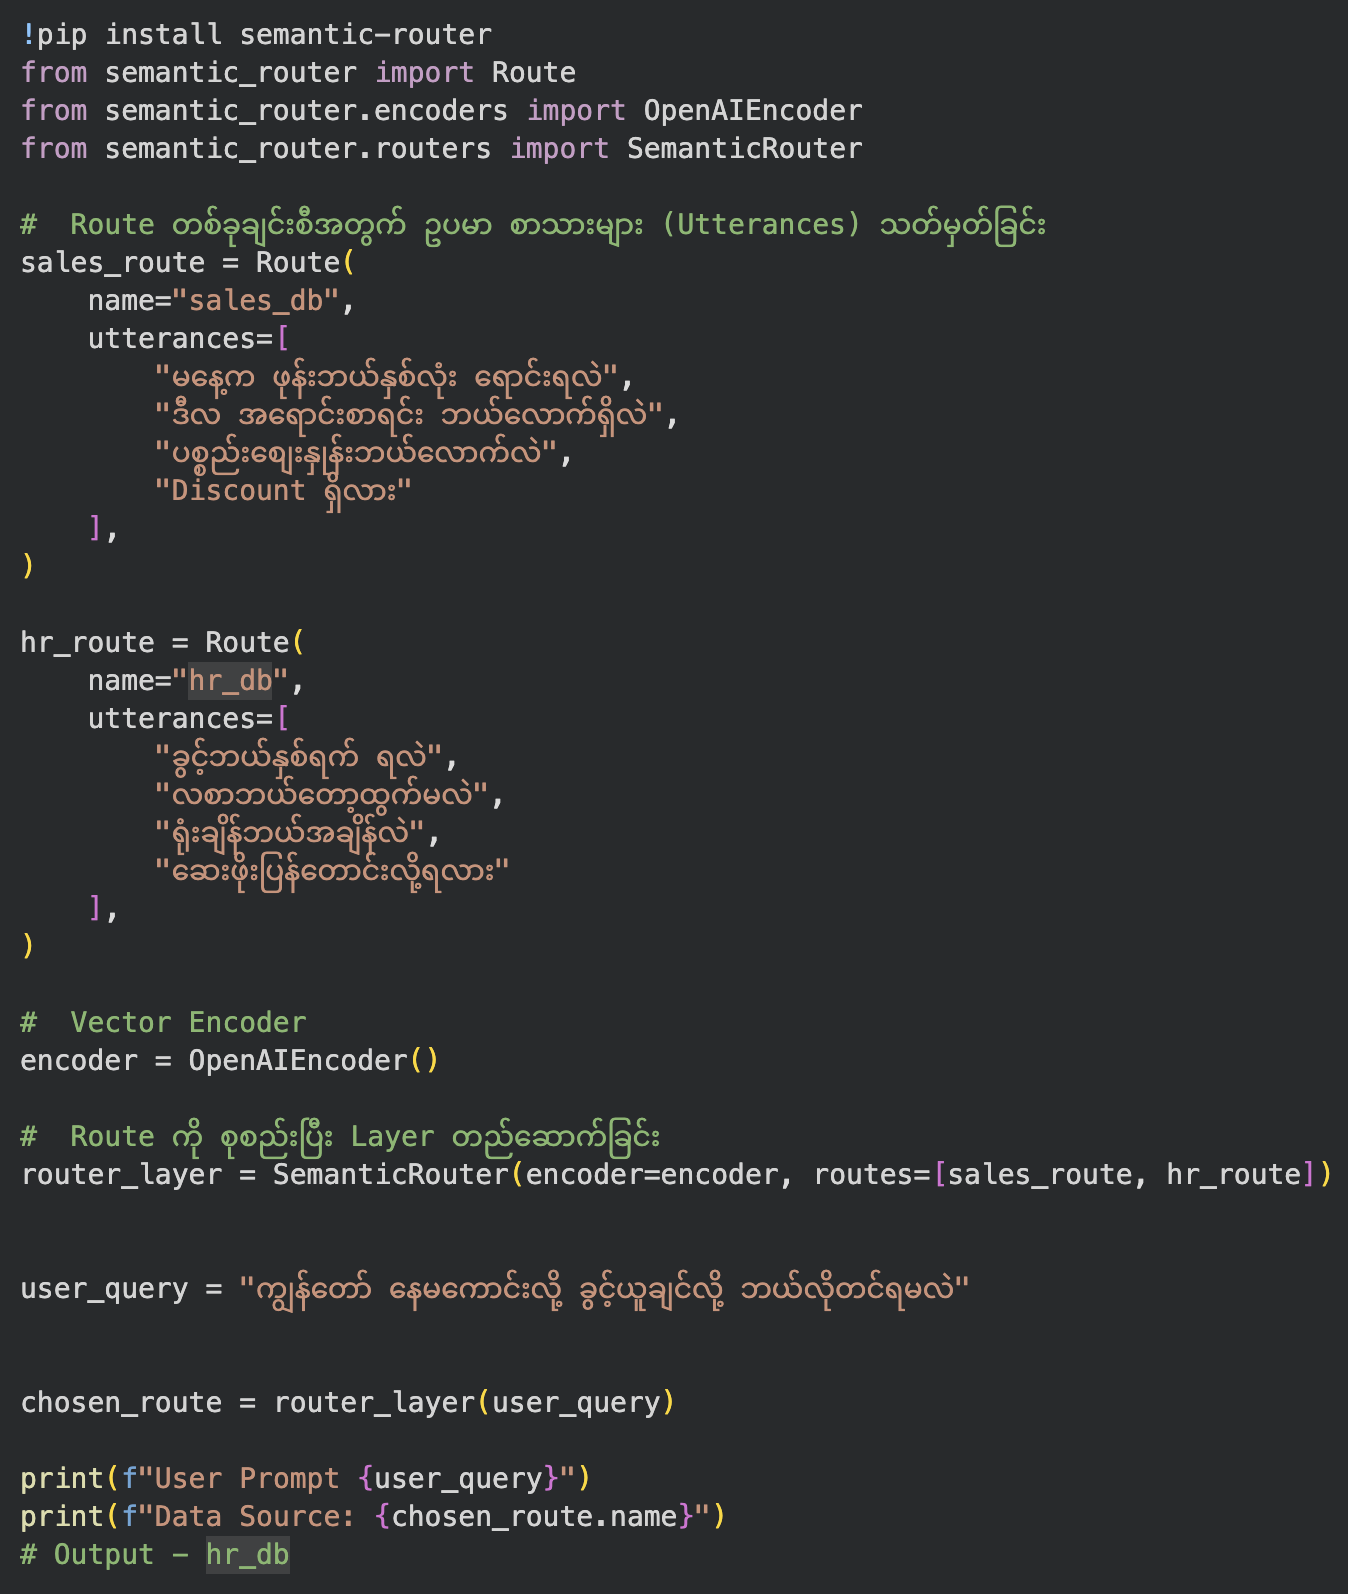
Semantic Routing
လက်ရှိ RAG တွေမှာ အသုံးအများဆုံးနဲ့ အမြန်ဆုံး နည်းလမ်းဖြစ်ပါတယ်။ LLM ကို Prompt နဲ့ ခေါ်စရာမလိုဘဲ Vector Embeddings ကို နှိုင်းယှဉ်ပြီး လမ်းကြောင်းခွဲပေးတာပါ။ semantic-router ဆိုတဲ့ Library ကို သုံးထားပါတယ်။
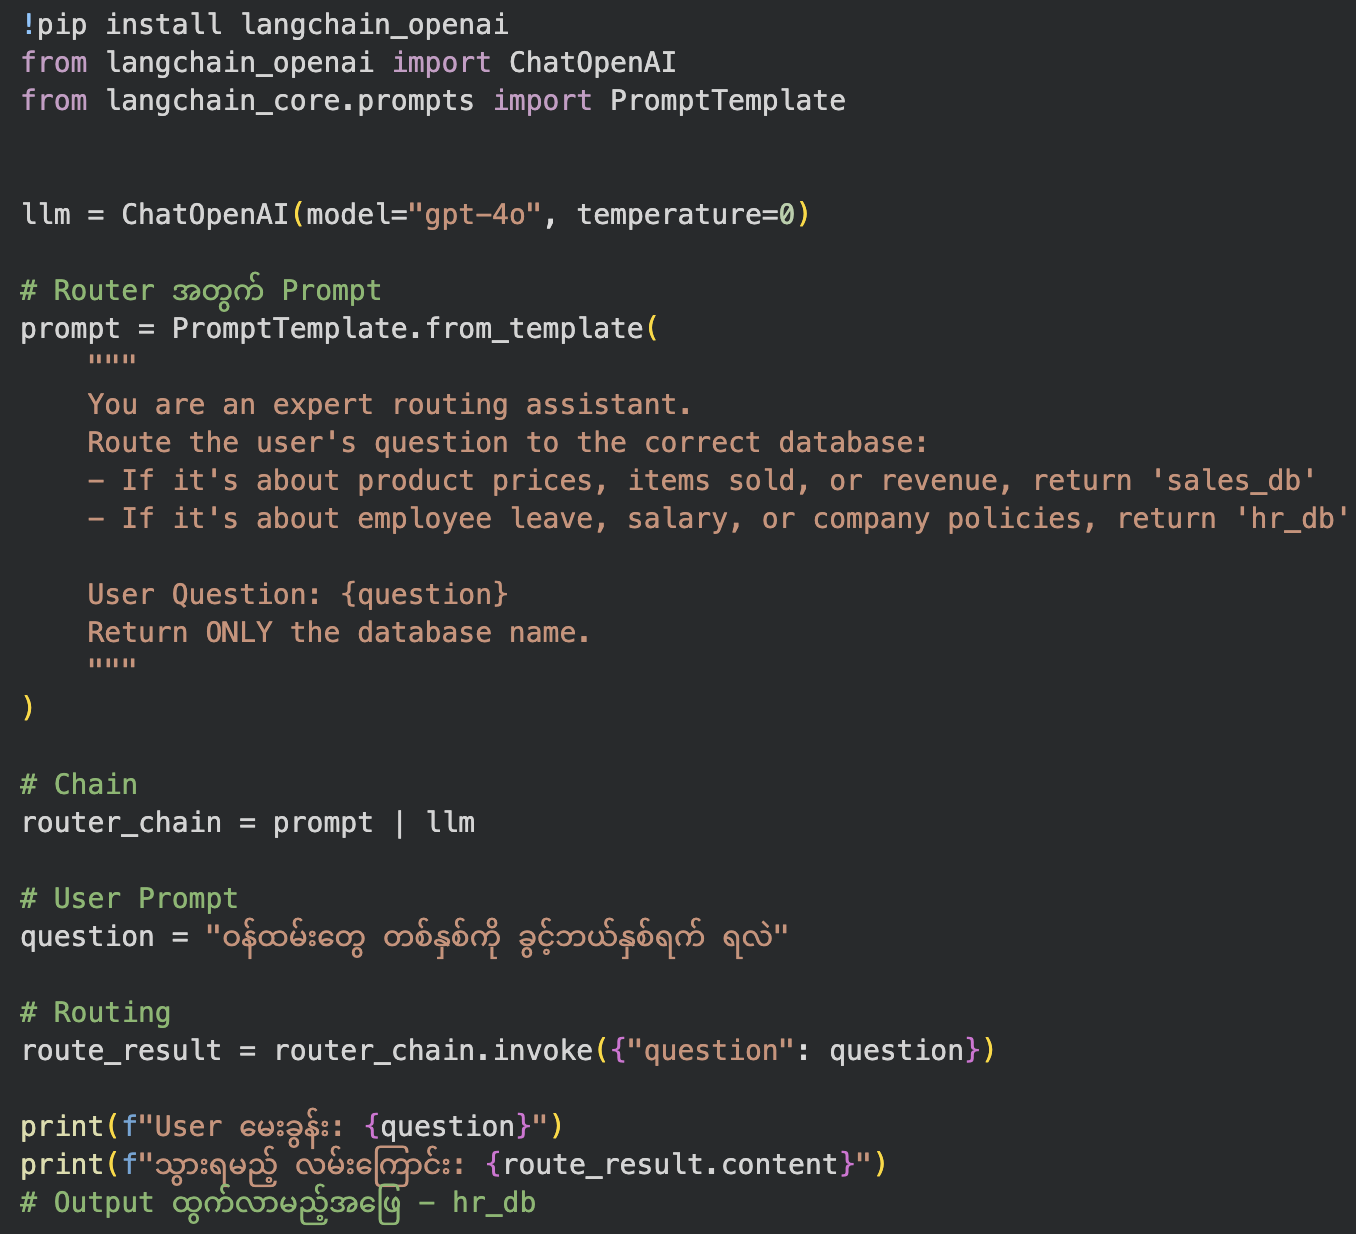
LLM-based Routing
LangChain ကိုအသုံးပြုထားပါတယ်
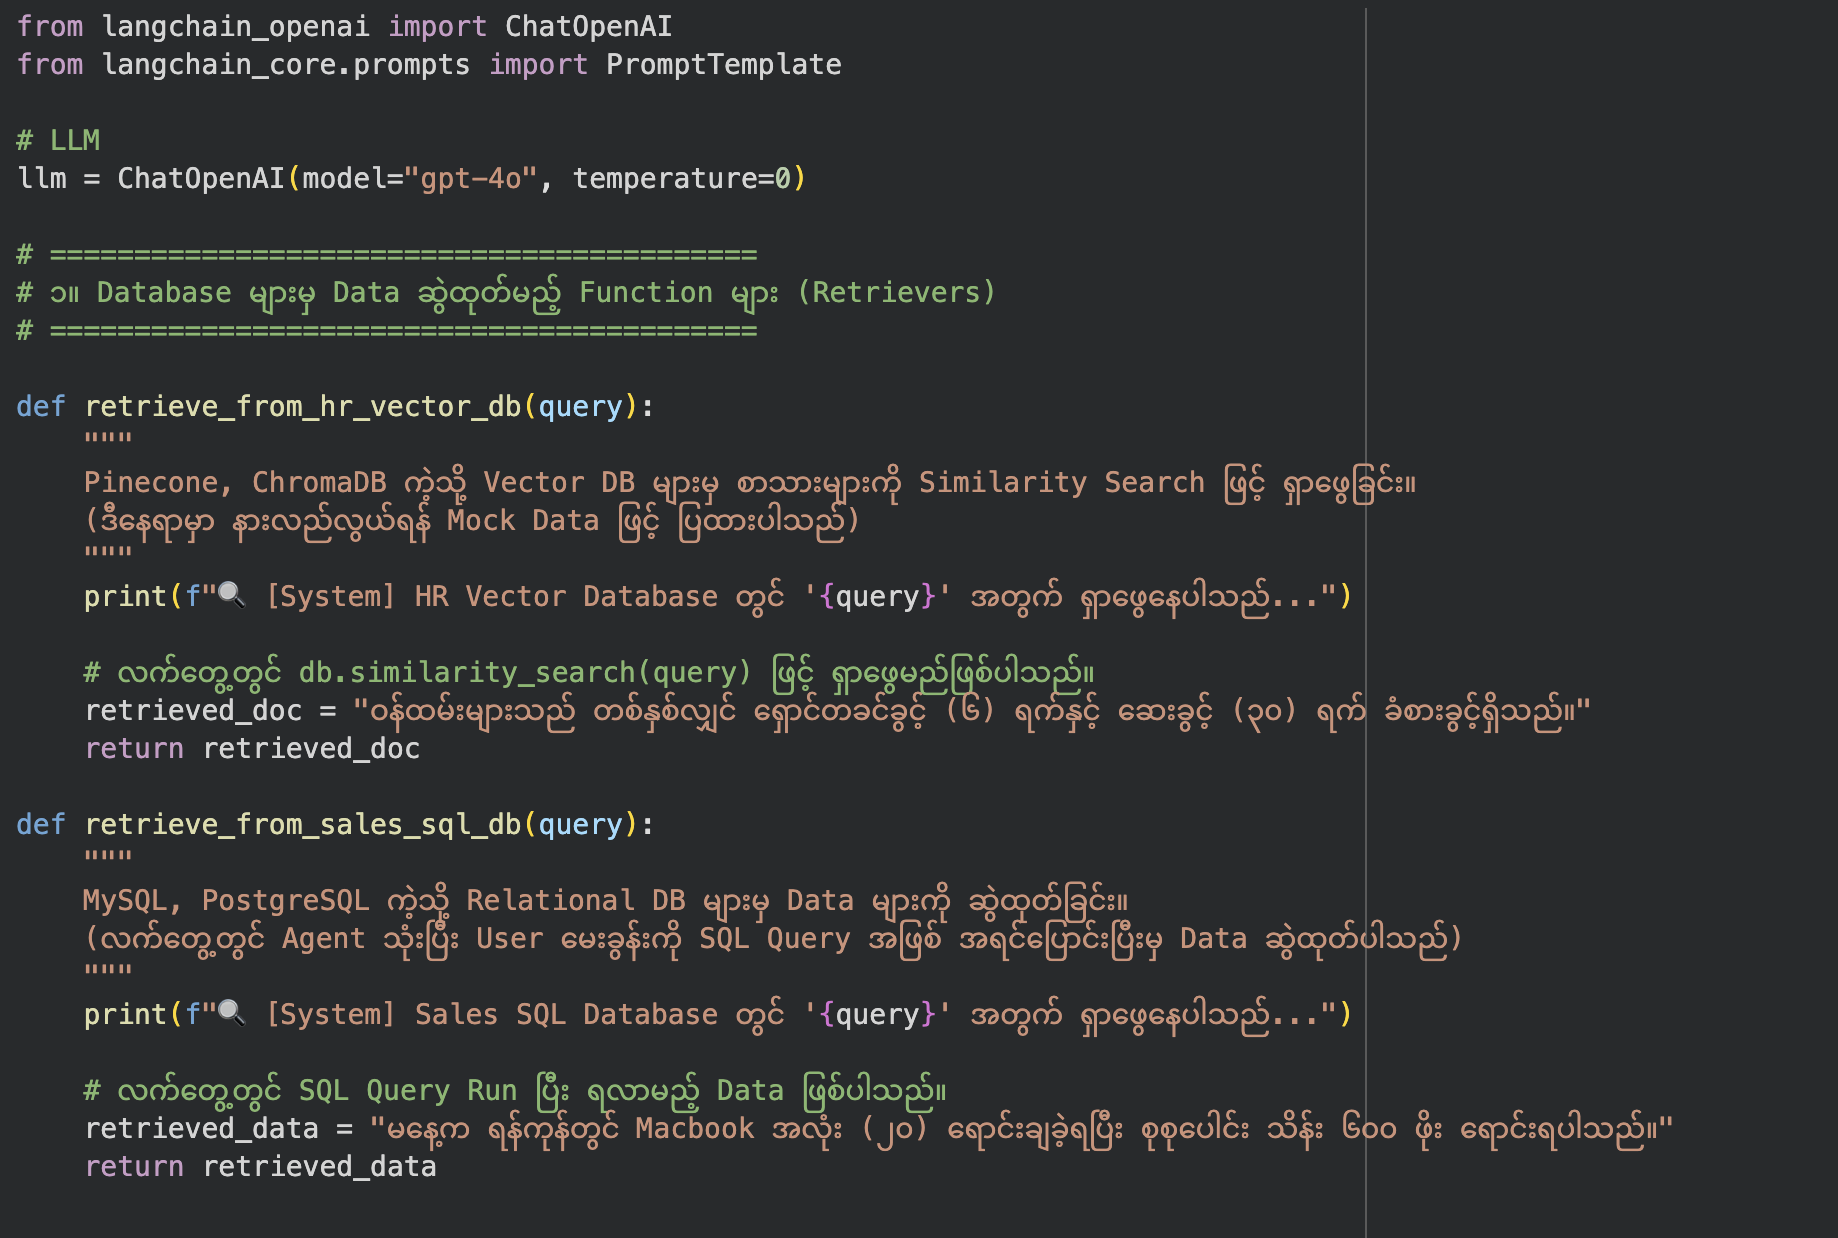
အပေါ်ကလို Routing တွေလုပ်ပြီးလို့ ဘယ်လမ်းကြောင်းကို သွားရမလဲ (ဥပမာ - hr_db လား၊ sales_db လား) သိပြီဆိုရင်တော့ အဲဒီ သတ်မှတ်ထားတဲ့ Database ဆီကနေ အချက်အလက်တွေကို သွားရောက်ဆွဲထုတ် (Retrieve) ရပါမယ်။
ဒီနေရာမှာ စိတ်ဝင်စားစရာကောင်းတာက Database အမျိုးအစားပေါ် မူတည်ပြီး ဆွဲထုတ်တဲ့နည်းလမ်း (Retrieval Method) တွေ မတူကြတာပါပဲ။ HR Policy တွေက စာသားတွေဖြစ်လို့ Vector Database (Similarity Search) သုံးပြီး ရှာရပါတယ်။ Sales Data တွေက ကိန်းဂဏန်းတွေဖြစ်လို့ SQL Database (Text-to-SQL) သုံးပြီး ရှာရပါတယ် စသဖြင့်ပေါ့။ အောက်က Python Code မှာ Routing ရလဒ်ပေါ်မူတည်ပြီး မတူညီတဲ့ Database တွေဆီကနေ Data တွေဘယ်လို ခွဲထုတ်လဲဆိုတာကို ဥပမာအနေနဲ့ ရေးပြထားပါတယ်။
RAG ကိုဘယ်အချိန်မှာသုံးမလဲ
တစ်ချို့အခြေနေတွေမှာ အပေါ်က Meme လို RAG သုံးမလား ဒါမှမဟုတ် Fine Tune နဲ့ အဆင်ပြေတာမျိုးလဲရှိပါတယ်၊၊ RAG ကတော့ အပေါ်ပြောခဲ့သလို ကိုယ့်ရဲ့ Data warehouse/ Data Source တွေကို ချိတ်ဆက်ထားပြီး Data တွေက အမြဲပြောင်းလဲနေတဲ့အခါ ဥပမာ - နေ့စဉ် အရောင်းစာရင်း၊ ပစ္စည်းလက်ကျန် (Inventory)၊ နေ့စဉ် သတင်းတွေ။ Database ထဲ Data အသစ်ထည့်လိုက်ရုံနဲ့ AI က တန်းသိပါတယ် Fine Tune လိုမော်ဒယ်ကို ပြန်Trainပေးစရာ မလိုပါဘူး။ Update အခြေနေတွေကို မေးချင်တဲ့အခါသုံးပါတယ်။
တိကျမှန်ကန်ဖို့ အရမ်းအရေးကြီးတဲ့အခါ: Hallucination (ရမ်းဖြေခြင်း) ကို လုံးဝ လက်မခံနိုင်တဲ့ နေရာတွေ။ ဥပမာ - ကုမ္ပဏီရဲ့ Policy၊ ဥပဒေရေးရာ အချက်အလက်။
အချက်အလက် အရမ်းများတဲ့အခါ: စာမျက်နှာ ထောင်သောင်းချီတဲ့ PDF တွေ၊ မှတ်တမ်းတွေကို AI ကို ဖတ်ခိုင်းပြီး အဖြေထုတ်ခိုင်းချင်တဲ့အခါ။
Finetune ကတော့ ရှိပြီးသား LLM Model တစ်ခု ကို ကိုယ်ပိုင် Data/instruction တွေ နဲ့ ပြန် Train တာပါ။ ဥမမာ - ဆေးပညာ၊ ဥပဒေပညာလို Domain Sepefic Keyword တွေကို ထပ်ထည့် Train ချင်တာမျိုးကျ သုံးပါမယ်။
RAG သုံးရင်လဲ ဂရုပြုစရာလေးတွေတော့ရှိပါတယ်။
Garbage In, Garbage Out
"Database ထဲက Data ညံ့ရင်၊ AI ရဲ့ အဖြေလည်း ညံ့သွားမှာပဲ" ဖြစ်ပါတယ်။
Update မဖြစ်တော့တဲ့ Data ဟောင်းတွေ၊ အချက်အလက်အမှားတွေ၊ သို့မဟုတ် ဖတ်လို့မလွယ်အောင် ရှုပ်ထွေးနေတဲ့ Data Format တွေကို Database ထဲ ထည့်ထားမိရင် AI က အဲဒီအမှားတွေကိုပဲ ကိုးကားပြီး အဖြေမှားတွေဘဲ ထုတ်ပေးပါလိမ့်မယ်။
အယ့်တာကြောင့်ကိုယ်ချိတ်ထားတဲ့ Data တွေကို Update ဖြစ်ဖို့ရယ် Quality Data ရဖို့ Data Engineering Pricipincle တွေ လိုက်နာဖို့လိုပါတယ် Maintenance & Synchronization ပိုင်းမှာဆိုရင်လဲ လုပ်ငန်းတစ်ခုမှာ Data တွေက နေ့တိုင်း ပြောင်းလဲနေတာပါ။ ဥပမာ ပစ္စည်းဈေးနှုန်း ပြောင်းသွားတိုင်း Vector Database ထဲက အဟောင်းကို ဖျက်ပြီး အသစ်ပြန်သွင်း (Sync) နေရပါတယ်။ ဒီ Data Pipeline ကြီး အမြဲတမ်း အလုပ်လုပ်နေဖို့ ထိန်းသိမ်းရတာ Engineering overhead က တစ််ခါတလေ တော်တော်လေး လက်ဝင်ပါတယ်။ Company မှာ Data Engineer ကောင်းကောင်းရှိဖို့လဲလိုအပ်ပါတယ်။ နောက်ထပ် သတိပြုစရာလေးတွေကတော့ Retrieval Failures ပိုင်းဘဲဖြစ်ပါတယ်။
တစ်ခါတလေမှာ Database ထဲမှာ လိုတဲ့ အဖြေရှိနေပေမယ့် Retrieval က ဆွဲမထုတ်ပေးနိုင်တာမျိုး ဖြစ်တတ်ပါတယ်။
Chunking ပြဿနာ - Data တွေကို အပိုင်းငယ်လေးတွေ (Chunks) ခွဲတဲ့အခါ စာပိုဒ်တွေ ပြတ်တောက်သွားရင် အဓိပ္ပါယ်ပျက်သွားပြီး ရှာမတွေ့နိုင်တဲ့အခါလဲရှိပါတယ်၊၊
Keyword Missing - User Prompt ထဲက စကားလုံးနဲ့ Database ထဲက စကားလုံး မတူတဲ့အခါ (ဥပမာ - "ဈေးလျော့ပေးလား" လို့မေးပေမယ့် စာရွက်ထဲမှာ "အထူးပရိုမိုးရှင်း" လို့ပဲ ရေးထားတဲ့အခါ) Vector ရှာဖွေမှုက မမိတာမျိုး ရှိတတ်ပါတယ်။ Contextual ပိုင်းကိုသေချာလေး Evaluate ပြန်လုပ်ရပါတယ်။
နောက်တစ်ခုက Context Window ကန့်သတ်ချက် (Context Limits) ပါ AI မော်ဒယ်တိုင်းမှာ တစ်ခါဖတ်ရင် စာလုံးရေ ဘယ်လောက်ပဲ လက်ခံနိုင်တယ်ဆိုတဲ့ ကန့်သတ်ချက် Context Window Size limit ရှိပါတယ်။ ရှာလို့တွေ့တဲ့ အချက်အလက် (Retrieved Context) တွေက အရမ်းများနေရင် AI ဆီကို အကုန်ပို့ပေးလို့ မရပါဘူး။ အရေးကြီးတဲ့ အချက်အလက်တွေ ချန်ခဲ့ရတာမျိုး ဖြစ်တတ်ပါတယ်။
**"**RAG ဆိုတာ AI ကို ကိုယ်ပိုင်စာကြည့်တိုက် လုပ်ပေးလိုက်တာ ဖြစ်ပေမယ့်၊ အဲဒီစာကြည့်တိုက်ထဲက စာအုပ်တွေကို စနစ်တကျ မစီထားရင်၊ ဒါမှမဟုတ် စာကြည့်တိုက်မှူး (Retriever) က စာအုပ်ရှာမတတ်ရင် AI ကလည်း အဖြေမှန်ကို ပေးနိုင်မှာ မဟုတ်ပါဘူး။"
နောက်တစ်ခုက RAG flow ဖြစ်တဲ့ User Prompt ကို လက်ခံတယ် -> Vector ပြောင်းတယ် -> DB ထဲသွားရှာတယ် -> Data တွေဆွဲထုတ်တယ် -> AI ဆီပို့ပြီး အဖြေထုတ်တယ်အယ့်လို Process တွေများနေလို့ Response Time က Driect LLM/ Finetune တွေနဲ့ယှဥ်ရင်တော့ ပိုကြာပါတယ်။ ကိုယ့် RAG system ကိုသုံးမယ့် User က လက်ခံလောက်မယ့် Response time ဖြစ်ဖို့ လိုပါတယ်။
နောက်ဆုံးတစ်ခုအနေကတော့ Vector Database ဖိုး၊ Embedding API ဖိုး ၊ LLM API ဖိုးစသဖြင့် လစဉ်ကုန်ကျစရိတ်တွေ ကို ဂရုပြုရပါတယ် Company Project မဟုတ်ဘူး Personal စမ်းချင်တာဆိုရင်တော့ Free tier တွေ Token ဖိုးသက်သာတဲ့ LLM တွေနဲ့ စ စမ်းသင့်ပါတယ်။
ကိုးကား
All the meme/photos are from internet
https://github.com/Sabofxx/42/tree/main/tronc-commun-42/rag_against_the_machine
"Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks" by Patrick Lewis et al.
Pinecone, ChromaDB, and Milvus's doc
semantic-router python lib doc
OpenAI Developer Guidelines
About the author
Web3 and Data Science enthusiast
Comments
Join the discussionNo comments yet. Be the first to comment.


